1. 文字は何種類あるのか、なぜ分けて見るのか
世界の文字の数を数える最も実用的な基準は、コンピューターが使う国際標準のユニコードです。ユニコード・コンソーシアムは2025年9月9日にバージョン17.0を公開しました。新たに4,803文字を追加して合計159,801文字を登録し、文字体系(スクリプト)の数は172になったと発表しています。今回新たに加わった4つの文字体系は次のとおりです。中央アフリカのザガワの共同体が使う現代の文字ベリア・エルフェ、インド北東部のクルクの共同体のトロン・シキ、ベトナム北部のタイ・ヨーの共同体の伝統文字、そして古代アナトリアで使われたシデ文字です。文字は博物館の中だけにあるものではありません。今も作られ、標準に登録されている生きた道具なのです。
172を一列に並べても覚えられません。しかし、音の書き表し方でまとめると、いくつかの系統に整理できます。子音と母音をそれぞれ個別の文字で書くアルファベット。子音だけを書き、母音はおおむね省くアブジャド。子音字そのものに基本の母音が含まれ、ほかの母音は記号で変えるアブギダ。1つの音節を1つの文字で書く音節文字。そして、意味を持つ単位を文字とする表語文字です。この分類は文字の「良し悪し」を示すものではありません。各言語の音の構造に合わせて人々が選んだ、それぞれ異なる解決策を示しています。
2. アルファベットの誕生:数百の記号を20あまりに
ペンシルベニア大学博物館の説明によると、アルファベットはエジプトの象形文字に着想を得たカナン人が、早ければ紀元前1800年ごろに発明しました。カナン人はフェニキア人の祖先にあたります。また、最近シリアのウンム・エル=マッラで見つかった粘土の札は、紀元前2400〜2300年までさかのぼる可能性があります。アルファベットの大きな利点は文字の数でした。楔形文字や象形文字の数百の記号の代わりに、「アルファベットの学習者は20から30の文字を覚えるだけで」済んだのです。
同じ資料によると、最古のギリシア・アルファベットの碑文は、フェニキアの船が地中海を行き来していた紀元前700年代のものです。また、今日英語をはじめ多くの言語で使われるラテン・アルファベットは、ギリシア・アルファベットから発展したと説明しています。フェニキア文字は子音だけを書く体系で、ギリシア人が一部の文字を母音の表記に割り当て直した、という説明は広く知られています。ただし、本稿で確認した博物館の資料は、その詳しい過程までは扱っていません。そのため、ここでは結果だけを記します。ギリシア・アルファベットとラテン・アルファベットは、子音と母音をどちらも個別の文字で書く体系になりました。その方式が、今日世界で最も広く使われる文字の類型になっています。
アルファベットの起源の年代は、新たな発掘によってさらにさかのぼる余地があることがわかります。アルファベットの強みは文字数の少なさでした。しかし、それが文字の優劣を意味するわけではないと読み取れます。
3. アブジャド:アラビア文字はなぜ母音を省くのか
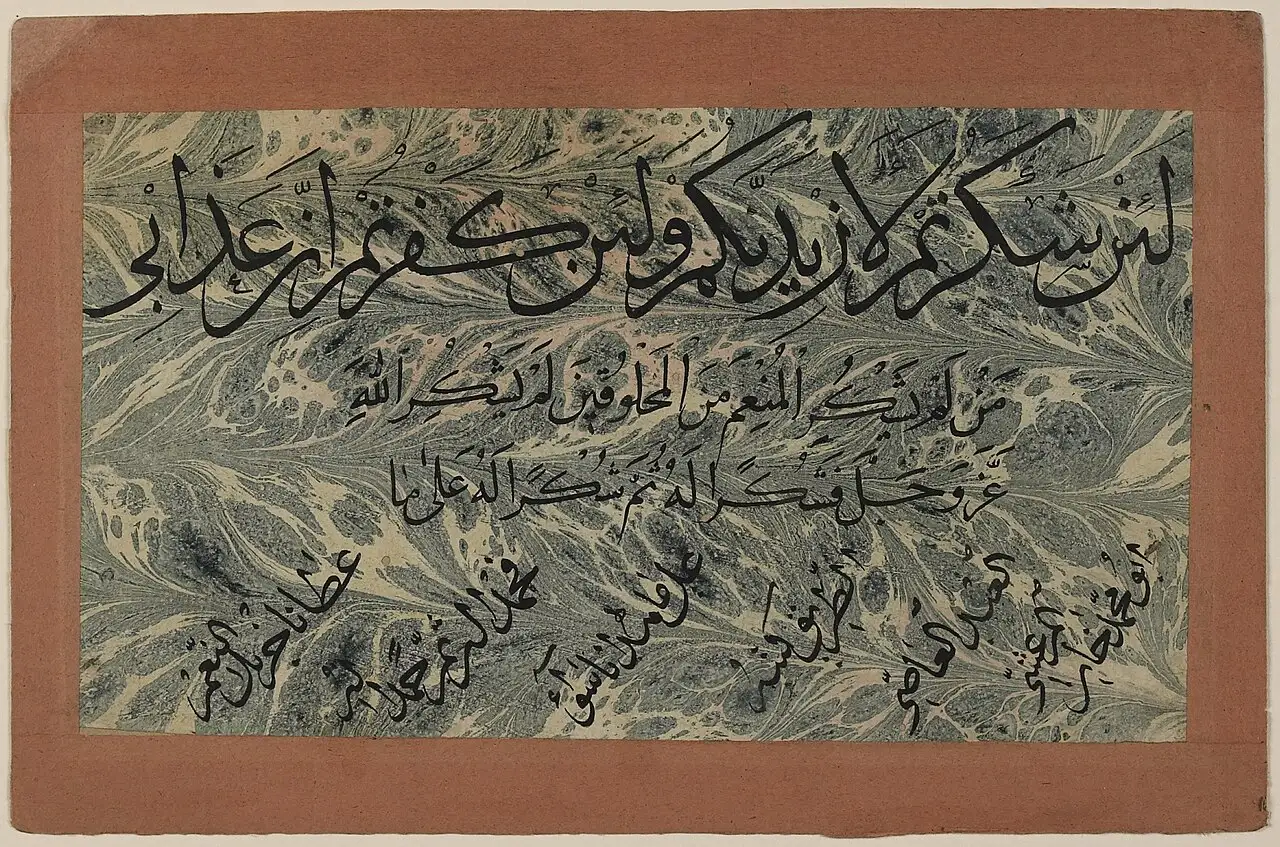
アラビア文字は、子音を中心とする文字、つまりアブジャドの代表例です。W3Cの国際化活動に携わるリチャード・イシダのアラビア文字正書法ノートは、アラビア文字を「短母音が通常書かれない」アブジャドと説明しています。基本の子音字は28字です。文章は右から左へ横書きにします。ただし、数字や挟み込まれたラテン文字は左から右へ読むため、1行の中で方向が混ざります。文字は常につなげて書く筆記体で、前後に何が来るかによって形が変わります。
母音がないわけではありません。長母音は、アリフ・ワーウ・ヤーの3文字が母音の役割を兼ねて表します。短母音は、文字の上下に付く小さな記号(ハラカート)で書くことができます。ただし、この記号は「クルアーンの本文、辞書、教材、発音をはっきりさせる必要がある箇所」でだけ使われます。日常の印刷物では、ほとんど省かれます。読み手がその言語を知っているので、子音の骨組みだけで単語を見分けられる仕組みです。同じ文字は、ペルシア語やウルドゥー語、アフリカの多くの言語でも、それぞれの音に合わせて文字を加えて使われています。文字と言語が一対一ではないことを示す例でもあります。
アルファベットと並べてみると、2つの類型の違いは、母音があるかないかより、母音を常に書くかどうかにあることがわかります。母音記号が辞書や教材で使われるという点は、省略が、その言語を知る読み手を前提とした選択であることを示しています。
4. アブギダ:子音字の中に母音が入っている
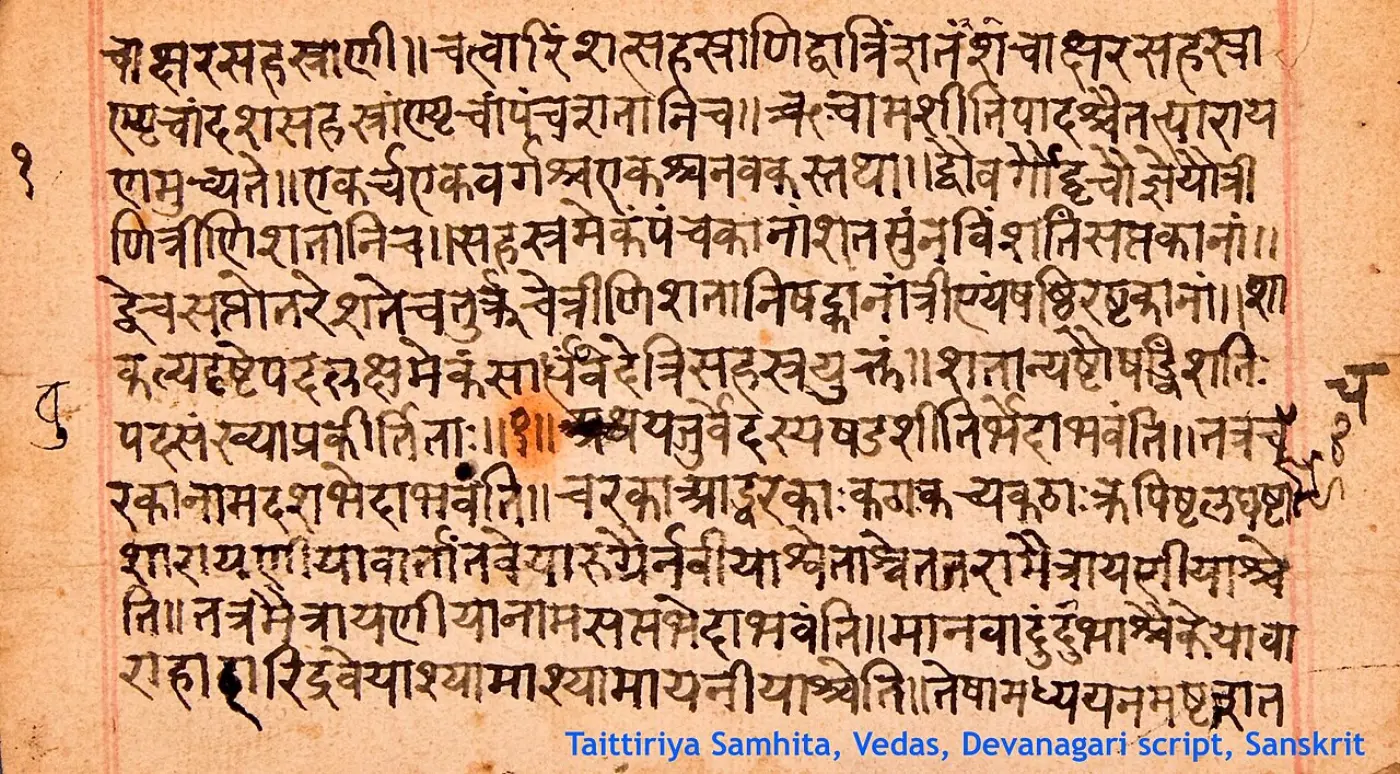
インドのデーヴァナーガリーをはじめとする南アジアの文字は、ユニコードの技術ノートが「アブギダまたはアルファシラバリー」と呼ぶ類型です。このノートによると、この類型では「子音字が子音+母音の音節を表し」ます。子音には基本として付いている母音(内在母音)があり、別の母音の音が必要なときはそれを上書きしなければなりません。内在母音の実際の発音は文字ごとに異なり、/ə/、/ʌ/、/ɔ/などの例があります。内在母音以外の母音を書くときは、サンスクリット語でマートラーと呼ばれる母音記号を使います。この記号は子音の左・右・上・下に、ときには複数の方向に同時に付けます。母音なしで子音だけを発音するときは、ユニコードでヴィラーマと呼ぶ小さな記号で内在母音を「消し」ます。子音が続くときは、文字の形を変えたり組み合わせたりします。デーヴァナーガリーの結合文字の60%では、半分の文字の形が使われます。これは、内在母音の音と歴史的に結びついた縦画が消えた形です。ノートは、これらの文字がすべてブラーフミーという共通の祖先から分かれたと説明しています。
アフリカには別のアブギダがあります。ユニコード標準の中核仕様は、エチオピア文字を「子音と母音の組み合わせを2次元の行列で示す」伝統を持つ文字と説明しています。符号化もその構造に沿っています。43の子音と8の母音を掛け合わせた、344の概念上の音節で組まれていると記しています。この文字の名前の由来となったゲエズ語は、今では典礼言語としてだけ残っています。しかし文字そのものは、アムハラ語・ティグレ語・オロモ語など、東アフリカの多くの言語に採用されて使われています。同じ文書は、アフリカで近代に新しく作られた文字も記録しています。たとえば、西アフリカのマンデ系の言語を書くために1949年に作られ、右から左へ書くンコ文字があります。1830年代に作られ、1962年に標準の音節表ができたリベリア・シエラレオネのヴァイ音節文字もその一つです。1896〜1910年の間にカメルーン西部で作られたバムン音節文字もあります。
アブジャドと比べると、アブギダは母音を省かずに、基本値として決めておく解決策だと読み取れます。デーヴァナーガリーとエチオピア文字を並べてみると、同じ類型の中でも、母音の付け方や並べ方が異なることがわかります。
5. 音節文字と表語文字を併用する日本語
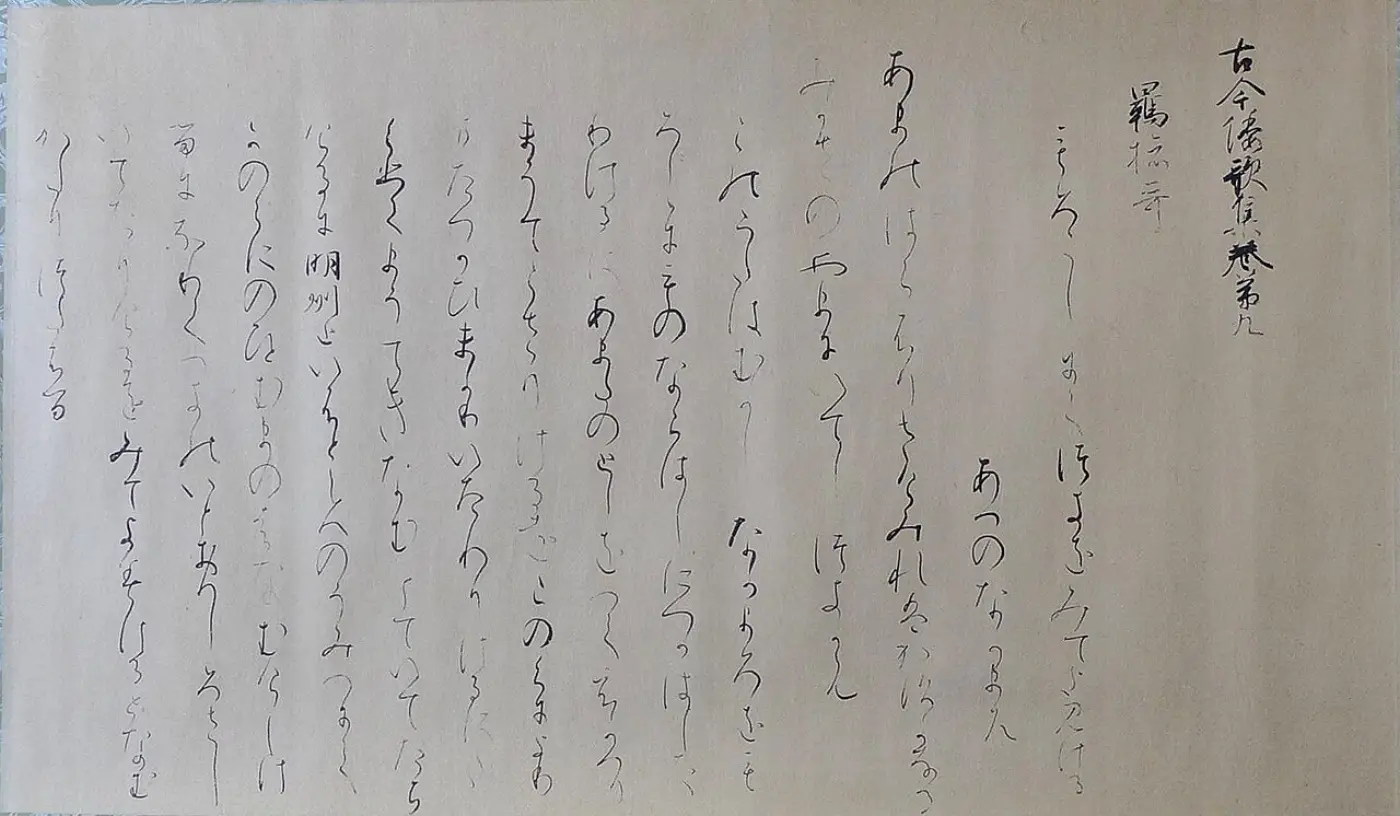
日本語は、1つの文の中で3種類の文字を一緒に使います。意味を持つ単位を書く漢字と、1つの音節を1つの文字で書く2種類の仮名(ひらがな・カタカナ)です。漢字はどれくらい知っていればよいのでしょうか。日本の文化庁は、2010年(平成22年)に内閣告示で改定した「常用漢字表」に2,136字を収めています。そして、この表の性格を「一般の社会生活における漢字使用の目安」と説明しています。つまり常用漢字は、法律で強制する漢字のすべてではありません。公文書や新聞のような一般の生活で、これだけあれば通じるとして定めた基準線です。
仮名は、それぞれ46字の基本の文字で日本語の音節を書くと広く紹介されています。ひらがなは主に助詞や語尾などの文法的な要素に、カタカナは外来語の表記などに使われます。1つの言語が表語文字と音節文字を、役割を分けて一緒に使う仕組みです。これは、文字の類型が言語ごとに1つずつ割り当てられるのではなく、必要に応じて組み合わせられることを示しています。
「目安」という説明からは、2,136字を日本語の漢字のすべてとは見なせないことがわかります。仮名と合わせて見ると、日本語の表記の負担は1つの文字の類型ではなく、組み合わせ全体に分散していると読み取れます。
6. ハングル:発音器官をかたどった文字
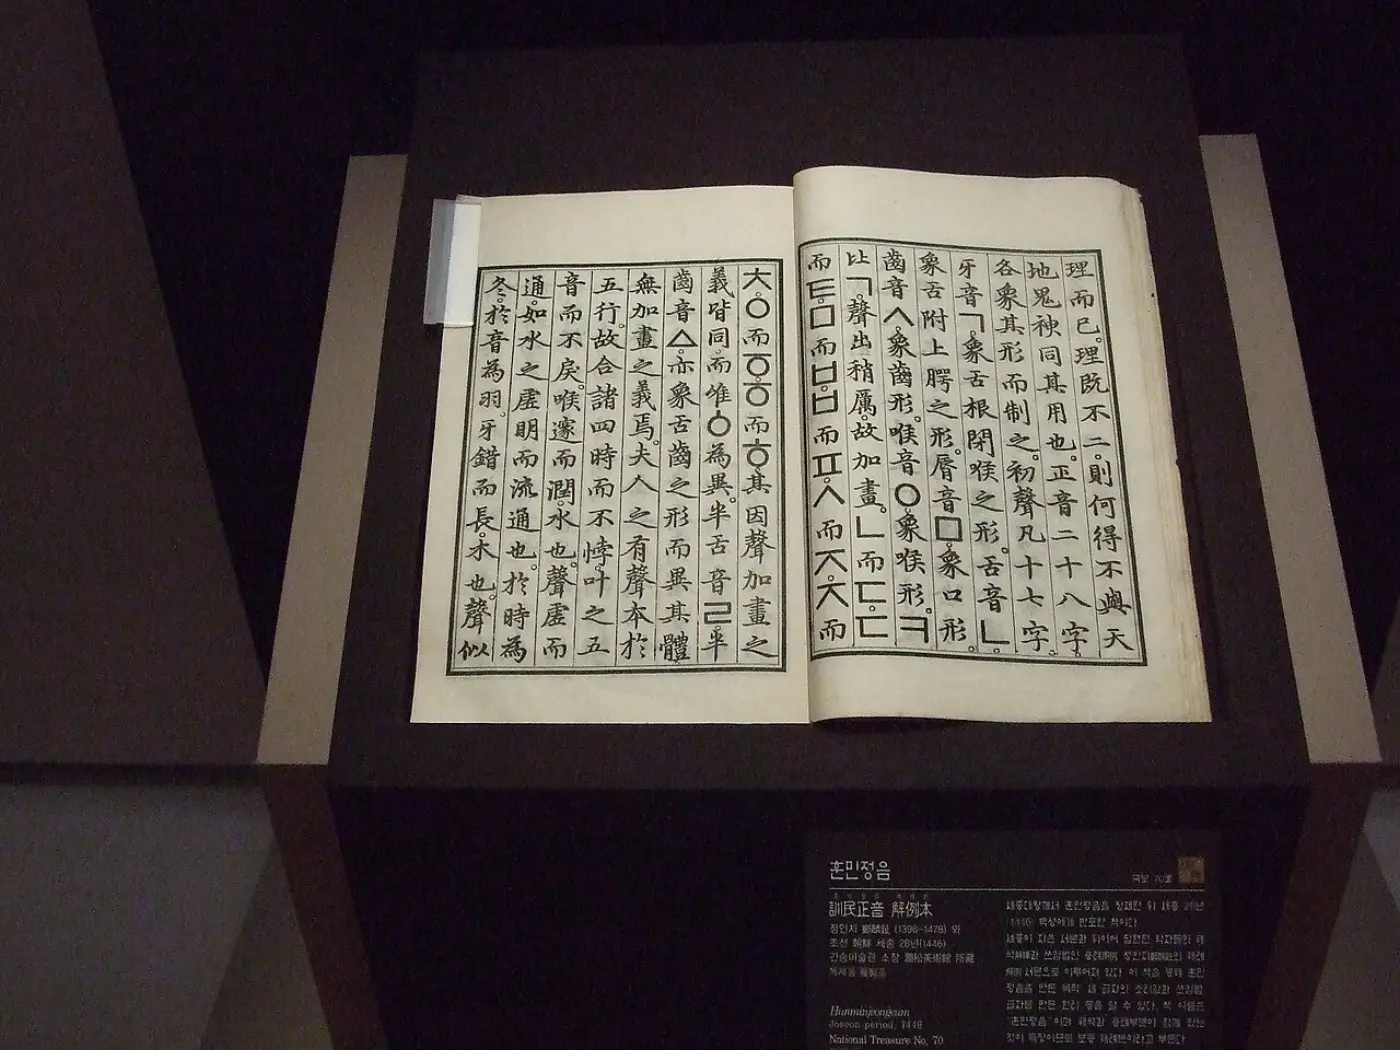
ハングルは、アルファベットのように子音と母音を個別の文字で書きます。しかし、文字を作った原理と記録が残っているという点で、世界の文字の歴史の中で特別な位置を占めています。国史編纂委員会の「ウリ歴史ネット」は、世宗が1443年(世宗25年)に28の文字を作り、1446年9月に『訓民正音』、いわゆる解例本を刊行したと記録しています。国立ハングル博物館の常設展「訓民正音、千年の文字計画」は、その28字が子音17字と母音11字からなると説明しています。基本の子音は発音器官の形をかたどり、母音は天・地・人の原理から導いたといいます。ユネスコは1997年に、この解例本を世界の記憶(世界記録遺産)に登録しました。その際、1446年陰暦9月に刊行されたこの本は、世宗が1443年に完成させた文字を公布した文書であり、集賢殿の学者たちによる解説と用例を収めていると紹介しています。原本は澗松美術館が所蔵しています。
今日使われているハングルは28字ではありません。『韓国民族文化大百科事典』の「字母」の項目によると、韓国語の語文規範は現在、ハングルの基本字母を子音14字、母音10字の計24字と定めています。15世紀の後舌低母音を表したアレア(ㆍ)、声門破裂音のヨリンヒウッ(ㆆ)、軟口蓋鼻音のイェシウン(ㆁ)、歯茎摩擦音の半歯音(ㅿ)は使われなくなりました。音が消えたり、ほかの文字に統合されたりしたためです。文字は作られた後も、その言語の音の変化に合わせて変わります。ハングルの24字は、その変化の結果です。
28字と24字は食い違った記録ではなく、異なる時点の数字であることがわかります。日本の常用漢字表と並べてみると、今日の文字数を政府機関が公開する規範が定めるという共通点も見えてきます。
7. 文字と言語は別のもの
本稿の例がくり返し示している事実が1つあります。文字と言語は別のものだということです。アラビア文字は、アラビア語だけでなくペルシア語やウルドゥー語も書き表します。エチオピア文字は、ゲエズ語が典礼言語に退いた後も、アムハラ語やオロモ語を書き表しています。反対に、1つの言語が複数の文字を使う日本語のような例もあります。ですから「どこかの国の文字」という言い方は、常に慎重に使う必要があります。文字は言語の音を入れる器です。器は借りて使うことも、作り直すことも、新しく作ることもできます。
そして、その器は今も作られています。1949年のンコ、1830年代のヴァイ、20世紀初めのバムン、そして2025年にユニコードに新たに登録されたベリア・エルフェとトロン・シキ。これらはどれも、共同体が自分たちの言語を書くために近現代に作った文字です。文字を「古いものほど正統」と見る見方は、この生きた歴史に合いません。ハングルは、1443年という制作年と制作原理を記録として持っています。それと同じように、新しい文字もそれぞれの理由と設計を持って生まれ、標準に加わります。
この区別で見ると、ユニコードの172は言語の数ではなく、文字体系の数であることがわかります。文字体系の数と言語の数を同じものとして数えられないことも、あわせて読み取れます。
8. 見慣れない文字に出会ったときに覚えておきたい3つのこと
第一に、文字数で文字の難しさや優劣を判断しないことです。アラビア文字は28字ですが、母音の省略やつなげ書きの規則を身につける必要があります。デーヴァナーガリーは、記号の結合規則が要です。漢字には、常用2,136字という基準線があります。それぞれの文字は、自分の言語に合わせて、複雑さを別の場所に置いているにすぎません。
第二に、文字の名前と言語の名前を区別することです。「アラビア文字で書いたウルドゥー語」「エチオピア文字で書いたアムハラ語」のように言えば、誤解が減ります。デジタルテキストの符号化やフォントが、言語ではなく文字体系の単位で区別して処理されるのも、同じ理由からです。
第三に、標準を確かめることです。ある文字がユニコードに登録されているか、どの文字体系に属するかは、ユニコード・コンソーシアムの公開資料で確認できます。各国の文字の規範(韓国の語文規範、日本の常用漢字表)は、それぞれの政府機関が公開しています。音を書き表す方式は4つあまりです。しかし、その方式を選んで使ってきた人々の歴史は、172の文字体系の一つひとつに、それぞれ異なる形で刻まれています。